Agilidade × IA: desenvolver deixou de ser Frontend + Backend — agora é responder pelo fluxo completo
A IA acelera a produção de código, mas o ganho só aparece quando produto, engenharia, segurança, release e operação funcionam como um fluxo completo.
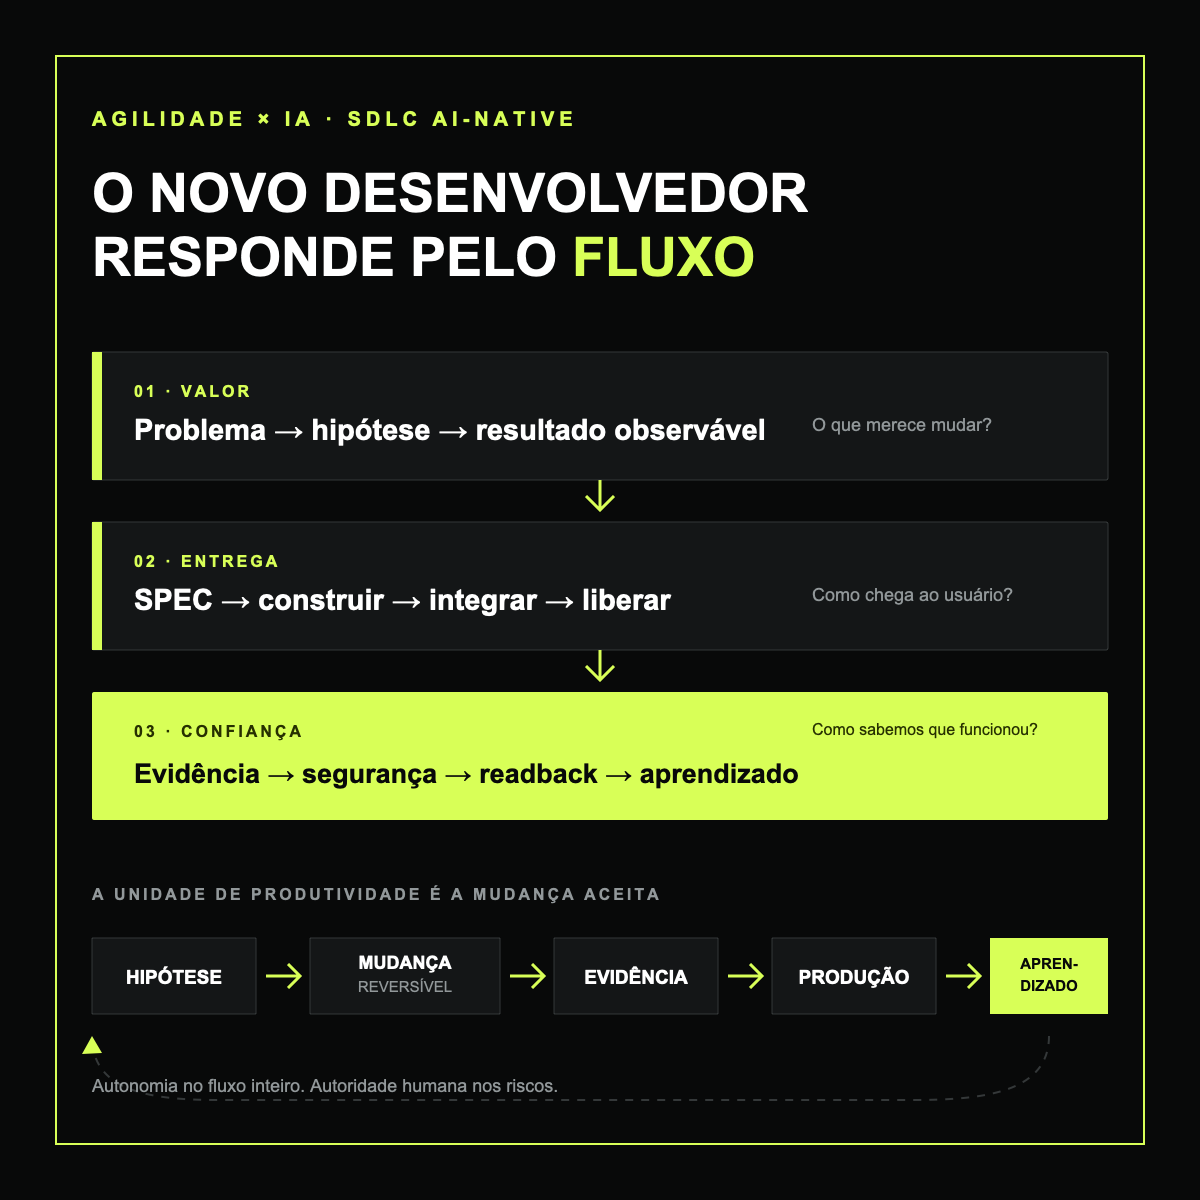
Quando o código acelera, o fluxo aparece
Quando a IA reduz o custo de gerar software, a vantagem deixa de estar em produzir mais código. Ela passa a estar em conduzir uma mudança inteira — do problema ao aprendizado em produção — com evidência, segurança e capacidade de voltar atrás.
Durante anos, a indústria organizou o desenvolvimento em caixas. Produto escreve a demanda. UX desenha. Frontend monta a interface. Backend expõe a API. QA testa. Segurança revisa. Operações publica e sustenta. Cada especialidade pode ser competente e, ainda assim, a mudança completa levar semanas para chegar ao usuário.
A IA pressiona esse modelo por um motivo simples: em tarefas bem delimitadas, ela pode comprimir fortemente algumas etapas locais — pesquisa, prototipação, escrita de código, testes iniciais, documentação — e tornar visíveis os atrasos que estavam fora do editor. Quando implementar leva horas, mas entender o problema, obter contexto, revisar, integrar, liberar e observar ainda leva dias, o gargalo apenas mudou de lugar.
É por isso que a discussão “Agile versus IA” começa pela pergunta errada. A IA não torna a agilidade obsoleta. Ela torna insuficiente uma interpretação pobre de agilidade: a ideia de que ser ágil é movimentar tickets, cumprir cerimônias ou produzir mais pontos por sprint.
Neste ensaio, tratamos agilidade como a capacidade de reduzir o tempo entre uma hipótese e uma evidência confiável para decidir. E a IA só cria vantagem quando encurta esse ciclo inteiro.
“A nova unidade de produtividade não é o código gerado. É a mudança aceita, operando com segurança e produzindo aprendizado.”
1. O que a pesquisa realmente diz sobre produtividade com IA
Os números sobre IA e desenvolvimento parecem contraditórios — até observarmos o que cada estudo mediu.
Um experimento controlado com GitHub Copilot recrutou e randomizou 95 profissionais para uma tarefa JavaScript bem delimitada. Entre os 70 participantes que concluíram a tarefa e a pesquisa — 35 em cada grupo —, quem utilizou a ferramenta terminou 55,8% mais rápido, com intervalo de confiança de 95% entre 21% e 89%. A diferença na taxa de conclusão foi pequena e não estatisticamente significativa. Em outro contexto, três experimentos de campo realizados na Microsoft, Accenture e uma empresa Fortune 100 combinaram dados de 4.867 desenvolvedores e produziram uma estimativa agrupada de 26,08% mais tarefas concluídas, com erro-padrão de 10,3% — e maior ganho entre profissionais menos experientes. Os experimentos individuais eram ruidosos, e “tarefas concluídas” é um proxy de produtividade, não uma medida de valor, qualidade ou SDLC completo.
Já um ensaio randomizado da METR, realizado entre fevereiro e junho de 2025, acompanhou 16 desenvolvedores experientes em 246 tarefas reais de grandes projetos open source que conheciam há anos. Com as ferramentas daquele período, eles demoraram 19% mais. Antes do estudo, esperavam ser 24% mais rápidos; depois, ainda acreditavam ter sido 20% mais rápidos.
Esse dado da METR é histórico, não uma fotografia das ferramentas atuais. Em fevereiro de 2026, os próprios pesquisadores avaliaram que o resultado do início de 2025 provavelmente já não representava o estado das ferramentas. Ao mesmo tempo, concluíram que o novo estudo não permitia estimar com confiança a magnitude da mudança: participantes passaram a evitar trabalhar sem IA, tarefas especialmente favoráveis a agentes deixaram de entrar no experimento e o uso concorrente de múltiplos agentes tornou o tempo mais difícil de medir.
Em conjunto, os estudos sugerem conclusões mais interessantes do que a disputa por um único percentual:
O DORA 2025 resume essa dinâmica dizendo que a IA funciona como um amplificador: ela amplia tanto as forças quanto as fragilidades existentes. Segundo a síntese oficial do Google Cloud, em uma amostra próxima de 5 mil profissionais, 90% já usavam IA, mais de 80% percebiam ganho de produtividade e 30% declaravam pouca ou nenhuma confiança no código gerado. O estudo de 2025 já encontrou associação positiva com throughput e desempenho do produto, mas a adoção também permaneceu associada a maior instabilidade na entrega.
Na análise DORA sobre o impacto da IA generativa no desenvolvimento, cada aumento de 25% na adoção apareceu associado a melhora de 7,5% na qualidade percebida da documentação, 3,4% na qualidade percebida do código e 3,1% na velocidade de revisão. Ao mesmo tempo, surgiu associação com redução de 1,5% no throughput de entrega e de 7,2% na estabilidade. São relações observacionais, não prova de causalidade. O resultado é compatível com o risco, discutido pelo DORA, de lotes maiores e gargalos nas etapas seguintes quando uma etapa acelera sem que testes, integração e entrega acompanhem.
- IA tende a ajudar mais quando a tarefa é bem especificada, o contexto é acessível e o resultado pode ser verificado com clareza;
- o ganho pode cair ou se inverter em bases complexas, com conhecimento tácito elevado, padrões rigorosos ou alto custo de revisão;
- percepção de velocidade não é uma medição confiável do resultado;
- mais tarefas ou mais código não provam maior valor, qualidade ou estabilidade;
- a ferramenta muda rapidamente, mas a qualidade do sistema organizacional continua sendo decisiva.
2. O código ficou mais barato. O contexto e a consequência, não.
Quando a geração de código era cara, boa parte da organização foi desenhada ao redor dela. Especialidades, estimativas, carreiras e métricas passaram a tratar implementação como o centro do sistema.
Agora, em alguns cenários bem delimitados, um agente pode produzir rapidamente uma primeira versão de interface, endpoint, migração, teste e documentação. Isso não significa que a mudança esteja pronta. Ainda é preciso responder:
IA pode ajudar a responder várias dessas perguntas. Ela não pode tornar as perguntas dispensáveis.
O SWE-bench mostra o avanço dos agentes em trabalho real: são 2.294 instâncias de tarefas construídas a partir de issues e pull requests de 12 repositórios Python, avaliadas por testes que falham antes do patch e passam depois. É um benchmark importante porque exige navegação, edição e execução. Mas seu próprio desenho também mostra o limite: resolver uma tarefa com testes não equivale a descobrir a necessidade, escolher o trade-off, aprovar o risco, operar o serviço ou confirmar valor para o usuário.
Patch aprovado por testes é uma evidência. Não é o sistema inteiro de decisão.
- Qual problema estamos resolvendo e para quem?
- Qual resultado de negócio ou comportamento do usuário esperamos mudar?
- Quais regras, exceções, direitos e restrições existem no domínio?
- A arquitetura suporta a mudança sem criar dívida perigosa?
- Os dados têm qualidade, base legal, proteção e rastreabilidade?
- O comportamento foi testado, inclusive nos casos que não cabem em um teste unitário?
- A mudança pode ser liberada progressivamente e revertida rapidamente?
- Saberemos, em produção, se funcionou e para quem não funcionou?
- Quem tem autoridade para aceitar o risco residual?
3. Frontend e Backend continuam importantes — mas deixam de ser fronteiras de responsabilidade
Frontend, backend, dados, segurança, plataforma e operações continuam sendo disciplinas profundas. O que muda é o lugar que elas ocupam.
No modelo fragmentado, cada papel otimiza sua etapa e entrega para o próximo. No modelo orientado a fluxo, uma pessoa ou time é responsável por conduzir uma mudança de valor através das especialidades necessárias. Isso não transforma todos em especialistas de tudo. Transforma o resultado, e não a camada técnica, no eixo da responsabilidade.
A experiência de Full Cycle Developers da Netflix é instrutiva. A empresa concluiu que especialistas separados podiam ser muito eficientes dentro de cada segmento e, ao mesmo tempo, criar ineficiência no ciclo completo por meio de handoffs, perda de contexto e feedback lento. O modelo “operate what you build” tornou os times responsáveis por design, desenvolvimento, testes, deploy, operação e suporte.
Mas a Netflix também descreve os custos: maior carga cognitiva, necessidade de treinamento, risco de sobrecarga e burnout. O modelo só se sustenta com ferramentas self-service, automação, rotações, capacidade disponível e times centrais especializados que transformam conhecimento de segurança, confiabilidade e infraestrutura em componentes reutilizáveis. O white paper de plataformas da CNCF e o modelo profissional de Team Topologies ajudam a desenhar essa combinação entre times orientados ao fluxo, plataforma, capacidade habilitadora e especialistas — como referências contextuais, não receitas causais ou organogramas universais.
Portanto:
“Autonomia não é executar tudo sozinho. É conseguir conduzir o fluxo, produzir evidência e convocar profundidade onde o risco exige.”
4. O SDLC AI-native: da intenção ao aprendizado
O SDLC tradicional costuma ser desenhado como uma sequência de departamentos. Um SDLC AI-native deve ser desenhado como um circuito de evidência.
Essa visão também recupera fundamentos de continuous delivery: pequenos lotes, software sempre deployável, testes confiáveis, segurança incorporada, observabilidade e feedback rápido. A IA amplia a capacidade de produzir; essas práticas impedem que produção abundante vire risco abundante.
- RESULTADO DE NEGÓCIO
- 1. Descobrir o problema, o usuário e a consequência
- 2. Especificar intenção, exemplos, limites, risco e aceite
- 3. Desenhar produto + UX + arquitetura + dados + operação
- 4. Planejar pequenos lotes, dependências, evidências e rollback
- 5. Construir com pessoas e agentes
- 6. Testar código + avaliar comportamento + revisar segurança
- 7. Integrar, revisar e produzir evidência verificável
- 8. Liberar progressivamente
- 9. Observar qualidade, custo, adoção, risco e incidentes
- 10. Expandir | corrigir | reverter | aprender
Etapa 1 — Intenção
O fluxo começa antes do backlog. Define problema, usuário, resultado esperado, consequência de errar e restrições. A IA pode pesquisar, organizar evidências e comparar alternativas; a liderança de produto continua responsável por intenção e prioridade.
Etapa 2 — Contexto
O agente precisa encontrar arquitetura, código, decisões anteriores, glossário do domínio, incidentes, padrões, políticas e dados relevantes. Sem contexto governado, a fluência do modelo mascara suposições.
Etapa 3 — Especificação executável
Critérios de aceite não devem viver apenas em uma frase. Precisam incluir exemplos, contratos, estados negativos, acessibilidade, privacidade, testes, evals e condições de liberação. Quanto maior o risco, mais explícita a especificação.
Etapa 4 — Plano em pequenos lotes
Um bom plano reduz blast radius. Separa mudanças reversíveis, explicita dependências, define evidências e prepara rollback. O objetivo não é criar um documento longo; é remover ambiguidades que custariam muito mais depois.
Etapa 5 — Execução assistida ou agêntica
Pessoas e agentes podem escrever código, infraestrutura, migrações, testes, documentação e telemetria. A autonomia cresce conforme o ambiente consegue limitar acesso, fornecer ferramentas adequadas e observar efeitos.
Etapa 6 — Verificação independente
Quem gera não deve ser a única autoridade que aprova. Testes funcionais, evals de comportamento, segurança, arquitetura, performance, acessibilidade e proveniência precisam produzir evidência independente e reproduzível.
Etapa 7 — Decisão e release
Aprovação deve ser proporcional ao risco. Uma correção de texto e uma mudança em autorização financeira não podem compartilhar o mesmo caminho. Feature flags, canário, migrações compatíveis e rollback transformam a decisão de publicar em uma decisão controlada.
Etapa 8 — Operação
Logs, traces, métricas, SLOs, custo, incidentes, suporte e feedback humano mostram o que nenhum ambiente de teste consegue provar por completo.
Etapa 9 — Aprendizado
O ciclo fecha quando o resultado atualiza especificações, testes, evals, padrões e memória operacional. Sem esse retorno, a organização acelera produção sem aumentar inteligência.
5. Três camadas de autonomia
Para evitar a fantasia do “desenvolvedor que faz tudo”, é útil separar autonomia em três camadas.
Um desenvolvedor full-flow pode não ser a melhor pessoa para elaborar um threat model complexo, interpretar uma obrigação jurídica ou otimizar um banco de dados crítico. Sua responsabilidade é perceber que a mudança alcançou esse limite, envolver o especialista correto e manter o fluxo e a evidência íntegros.
Isso preserva especialização sem recriar silos. Especialistas deixam de ser estações obrigatórias para toda mudança e passam a atuar onde sua profundidade realmente altera o risco, além de codificar conhecimento em políticas, ferramentas, templates e golden paths.
- CAMADA DE VALOR
- Problema → resultado → prioridade → regra → aceite
- CAMADA DE ENTREGA
- UX → frontend → backend → dados → integrações → infraestrutura
- CAMADA DE CONFIANÇA
- SPEC → testes → evals → segurança → CI/CD → observabilidade → rollback
- AUTONOMIA ≠ executar tudo sozinho
- AUTONOMIA = conduzir as três camadas, provar o que foi feito
- e chamar profundidade onde o risco exige
6. O novo contrato entre pessoas e agentes
Sistemas agênticos integrados a ferramentas já conseguem, em escopos delimitados, adquirir contexto, explorar um repositório, propor planos, implementar, testar, revisar e preparar artefatos para release. Mas capacidade técnica e autoridade organizacional são coisas diferentes. O SWE-Lancer, com mais de 1.400 trabalhos reais avaliados em US$ 1 milhão, reforça o limite: em sua publicação original, os modelos de fronteira ainda não resolviam a maioria das tarefas.
Um contrato operacional claro precisa definir:
Autonomia confiável não é ausência de controle. É controle incorporado ao caminho padrão.
O NIST Secure Software Development Framework organiza práticas em preparar a organização, proteger software e artefatos, produzir software seguro e responder a vulnerabilidades. O perfil NIST SP 800-218A adiciona práticas específicas para o desenvolvimento de modelos de IA e para produtores ou adquirentes de sistemas que usam esses modelos, sempre em conjunto com o SSDF 1.1. A mensagem é direta: segurança, rastreabilidade e resposta não são uma revisão tardia; pertencem ao SDLC.
Uma pesquisa histórica, Asleep at the Keyboard?, encontrou vulnerabilidades em cerca de 40% de 1.689 programas gerados em cenários de risco. O percentual não descreve modelos atuais: o estudo avaliou uma geração inicial do Copilot com prompts sintéticos. Seu valor aqui é demonstrar um princípio duradouro — código plausível não constitui garantia de segurança, e o mesmo agente não deve ser a única autoridade que gera e aprova.
- Escopo: quais repositórios, ambientes, dados e ferramentas o agente pode acessar;
- Objetivo: o resultado desejado e o que está explicitamente fora da tarefa;
- Risco: impacto potencial, reversibilidade e nível de aprovação necessário;
- Evidência: testes, evals, análises, artefatos e readbacks obrigatórios;
- Autoridade: o que o agente pode apenas propor, o que pode executar e o que exige aceite humano;
- Observação: como custo, comportamento, erros e mudanças de estado serão registrados;
- Interrupção: quando parar, escalar, reverter ou pedir uma decisão.
7. Um exemplo completo: contestar uma decisão de IA
Considere uma história aparentemente simples: “o usuário precisa contestar uma decisão tomada com auxílio de IA”.
Se o trabalho for dividido apenas em frontend e backend, o time talvez crie um botão, um formulário e um endpoint. A mudança pode passar nos testes e continuar incompleta.
O fluxo integral precisa atravessar:
Nenhuma camada isolada entrega esse resultado. O responsável pelo fluxo precisa integrar especialistas, agentes e evidências até que a mudança possa ser aceita — ou conscientemente recusada.
Como esse caso envolve direitos, explicação, contestação e consequência, o NIST AI Risk Management Framework complementa o SSDF ao organizar governança, mapeamento, mensuração e gestão de riscos próprios de sistemas de IA. É um framework voluntário e precisa ser convertido em decisões e controles do contexto real.
- Resultado: reduzir decisões injustas sem criar uma fila impossível de atender.
- Política: definir quais decisões são contestáveis, prazos, responsáveis e direitos do usuário.
- UX: explicar a decisão em linguagem compreensível, coletar contexto e mostrar o estado do recurso.
- Frontend: acessibilidade, proteção contra envios duplicados, estados de erro e acompanhamento.
- Backend: autorização, idempotência, prazo, roteamento e integração com o processo humano.
- Dados: trilha de auditoria, retenção, privacidade e separação entre evidência e informação sensível.
- IA: evals para explicação, consistência, vieses, recusa e comportamento fora de distribuição.
- Segurança: abuso, exfiltração, prompt injection, escalada de privilégio e vazamento entre usuários.
- Operação: volume, tempo de resposta, fila, custo, incidentes e capacidade do time responsável.
- Release: exposição progressiva, segmento piloto, feature flag e caminho de rollback.
- Aprendizado: quantas decisões foram revistas, quais regras falharam e o que mudou no produto.
8. Onde o Trustyu Forge se encaixa
No modelo proposto, o Trustyu Forge atua como disciplina e contrato do fluxo. Seu papel não é gerar mais artefatos; é transformar intenção, risco e aceite em um caminho de mudança verificável.
O ciclo que orienta a iniciativa — SPEC → EXPLORE → PLAN → RED → IMPLEMENT → GREEN → SELF-VERIFY → PR — foi desenhado para reduzir um problema importante da engenharia com agentes: separar fluência de prova.
Esse ciclo qualifica a mudança até a revisão. Ele não substitui liberação, observação, reversão e aprendizado em produção, que pertencem ao circuito mais amplo do SDLC.
O Forge adiciona proporcionalidade. Mudanças triviais não devem carregar a burocracia de uma alteração crítica; mudanças estruturais, de segurança ou com consequências difíceis de reverter exigem especificação, decisão arquitetural, threat model e aprovação independente mais fortes.
Essa é a formulação mais precisa:
Isso não significa que toda equipe ou repositório já execute todos os controles de forma automática. Um padrão documentado, por si só, não prova adoção nem operação. A maturidade real aparece quando o fluxo deixa evidência reproduzível: gate executado, resultado registrado, decisão atribuída e estado de produção confirmado.
- SPEC registra intenção, exemplos, limites e condições de aceite;
- EXPLORE encontra contexto, dependências e decisões existentes antes de propor mudança;
- PLAN decompõe o trabalho, explicita risco, evidência e rollback;
- RED prova que o teste ou controle realmente detecta a ausência do comportamento;
- IMPLEMENT produz a menor mudança suficiente;
- GREEN demonstra o comportamento esperado sem quebrar o contrato anterior;
- SELF-VERIFY revisa o próprio trabalho, executa gates e registra limites;
- PR torna revisão, decisão e proveniência duráveis.
“Forge organiza o contrato, o risco e as evidências necessários para uma autonomia confiável.”
9. Onde o Trustyu AI Works se encaixa
Se o Forge estrutura o contrato, o Trustyu AI Works ocupa o plano de execução para recursos AI-native e integrações qualificadas, aproximando ferramentas, contexto e agentes em um ambiente controlado.
O valor de um workbench AI-native não está em ser uma nova janela de chat. No estado auditado, o AI Works sustenta capacidades como:
A visão mais ampla inclui escrita em repositórios, Code Ops e outras superfícies de execução. Essas possibilidades precisam permanecer identificadas como arquitetura-alvo até que cada integração esteja implementada, qualificada e observável. No estado auditado, branch, commit, push e PR genéricos para repositórios Git arbitrários ainda não compõem uma capacidade concluída.
Uma capacidade só deve ser tratada como operacional quando está realmente conectada ao catálogo, ao registro e ao dispatcher apropriados e quando seu resultado pode ser lido de volta. Ter uma ferramenta no código ou uma ação disponível na interface não prova que todo o SDLC esteja integrado, seguro ou pronto para produção.
- ler contexto e observar fontes integradas, inclusive GitHub no escopo já conectado;
- executar programas e validações no sandbox controlado;
- coordenar ferramentas que estejam catalogadas, registradas e autorizadas;
- registrar artefatos e evidências;
- operar o ciclo nativo de recursos com alvos imutáveis, readiness, promoção e rollback;
- manter limites de ambiente, autoridade temporária e consequência.
“AI Works aproxima execução, ferramentas e agentes; sua eficácia precisa ser medida pela parte do fluxo que consegue atravessar com evidência, não pela quantidade de ações disponíveis.”
10. Forge + AI Works: control plane e execution plane
Neste ensaio, propomos ler as duas iniciativas como planos complementares: Forge organiza contrato, risco e evidência; AI Works aproxima execução e ferramentas no escopo efetivamente qualificado. Essa é uma leitura arquitetural, não a afirmação de que todo o fluxo já opera de ponta a ponta.
Em uma frase:
O diferencial conjunto não é uma fábrica de código. É uma arquitetura-alvo para orientar mudanças comprováveis: intenção conhecida, execução rastreável, evidência independente, risco proporcional e feedback do mundo real.
- TRUSTYU FORGE — CONTROL PLANE
- intenção, princípios e políticas
- níveis de risco e limites de autonomia
- contexto e especificação
- critérios de aceite, testes e evals
- segurança, proveniência e auditoria
- aprovações e evidências obrigatórias
- ↓ tarefa autorizada
- ↑ evidência + telemetria
- TRUSTYU AI WORKS — EXECUTION PLANE
- (recursos nativos + integrações qualificadas)
- aquisição de contexto
- exploração, planejamento e decomposição
- execução por pessoas e agentes
- recursos nativos e artefatos associados
- validações e captura de evidências
- ambientes e ferramentas controlados
- release, observação e readback no escopo qualificado
“Forge torna a autonomia qualificável; AI Works é o plano de execução projetado para transformá-la, no escopo verificado, em fluxo operacional.”
O que está verificado — e o que ainda é arquitetura-alvo
Uma auditoria somente leitura realizada em 3 de novembro de 2026 encontrou elementos concretos dos dois lados.
No Forge, o repositório de runtime já contém CLI e checks, gate de feature spec, classificação de risco, pacotes de evidência e conformidade e workflows de lifecycle e readiness. A qualificação mais avançada está verificada no repositório proprietário que a executou; isso não equivale a adoção ou operação uniforme em toda a frota.
No AI Works, a arquitetura vigente expõe 12 tipos públicos de recurso, dos quais cinco possuem ciclo compilado e publicado. Nesse escopo há alvos imutáveis, orquestração durável, readiness, promoção e rollback, avaliações offline e online, gates e overrides auditáveis, além de um Assistant com autoridade temporária e efeitos controlados.
Também existem limites materiais que impedem chamar a combinação de “SDLC universal já operando de ponta a ponta”:
Essa distinção é estratégica. Implementado descreve o que existe no código. Verificado descreve o que passou por evidência reproduzível em um escopo definido. Operando exige comprovação no ambiente real. A ambição do SDLC completo deve orientar a arquitetura sem transformar roadmap em fato consumado.
- Code Ops genérico para qualquer repositório Git — incluindo branch, commit, push e PR — ainda é uma proposta, não uma capacidade concluída;
- o CI principal do AI Works está manualmente desabilitado; validações recentes dependem de execução local com evidências registradas nos PRs, além de workflows manuais de infraestrutura e release;
- o sandbox do Assistant possui contratos e isolamento implementados, mas sua qualificação operacional mais ampla continua parcial;
- a adoção do Forge 3.3 no AI Works permanece um piloto designado, ainda sem qualificação completa de source cut, deploy, recovery, segurança e revisão independente.
11. O loop operacional recomendado
Esse loop muda também a definição de pronto.
“Código concluído” significa apenas que uma etapa terminou.
“Mudança aceita” significa que:
- Hipótese
- Mudança pequena e reversível
- Testes + evals + segurança
- PR com evidências, limites e autoridade explícita
- Canário / rollout progressivo
- Telemetria + feedback humano
- ACEITAR → ampliar
- CORRIGIR → novo ciclo
- REVERTER → preservar operação
- APRENDER → atualizar SPEC, testes e evals
- o comportamento esperado foi comprovado;
- os principais riscos foram tratados ou conscientemente aceitos;
- a mudança foi integrada e liberada pelo mecanismo correto;
- seu estado real foi lido de volta;
- existe observabilidade suficiente para detectar degradação;
- existe um caminho testado ou plausível de reversão;
- a evidência fica disponível para revisão futura.
12. O que medir quando código deixa de ser o gargalo
Não use linhas de código, commits, tokens, número de prompts, PRs ou taxa de aceitação de sugestões como placar de transformação. Todos podem aumentar enquanto o valor diminui.
O framework SPACE demonstra por que produtividade não cabe em uma métrica. Ele combina satisfação e bem-estar, performance, atividade, comunicação e colaboração, eficiência e fluxo. A recomendação é observar várias dimensões em tensão, em níveis individual, de time e de sistema.
Um painel AI-native deve combinar:
Resultado
- adoção e sucesso do usuário;
- receita, conversão, risco ou custo evitado;
- tempo da hipótese até evidência real;
- satisfação e impacto operacional.
Fluxo
- lead time da mudança;
- frequência de deploy;
- WIP e tempo em fila por etapa;
- tamanho do lote;
- tempo do primeiro commit até produção verificada.
Estabilidade e recuperação
- change fail rate;
- deployment rework rate;
- failed deployment recovery time;
- incidentes e defeitos escapados;
- percentual de mudanças reversíveis.
Qualidade e risco
- pass rate de testes e evals independentes;
- vulnerabilidades e violações de política por mudança;
- regressões funcionais e comportamentais;
- cobertura de proveniência;
- cumprimento de SLOs.
Pessoas
- satisfação e bem-estar;
- carga cognitiva;
- tempo de foco e interrupção;
- colaboração e tempo de espera entre especialidades;
- sinais de burnout e on-call insustentável.
Agentes
O objetivo não é criar um índice mágico. É enxergar onde a velocidade local está aumentando o desempenho do sistema — e onde está apenas empurrando trabalho para outra fila.
- sucesso por classe e risco da tarefa;
- taxa de intervenção, override e rejeição;
- retrabalho depois da aprovação;
- custo por mudança aceita;
- tempo humano de supervisão;
- divergência entre autoavaliação do agente e resultado real.
13. Cinco anti-padrões da transição
1. Vibe coding sem contexto
O agente produz algo plausível, mas desconhece regras do domínio, decisões arquiteturais, incidentes anteriores e limites de operação. A primeira versão impressiona; a integração cobra a conta.
2. Tratar o PR como linha de chegada
Merge não é deploy; deploy não é operação saudável; operação saudável não é valor comprovado. O fluxo termina no aprendizado, não no Git.
3. Agente sem fronteira de autoridade
Dar ferramenta sem definir escopo, risco, aprovação e interrupção transforma automação em consequência imprevisível.
4. Automatizar um processo ruim
IA aplicada sobre filas, aprovações duplicadas, ambientes frágeis e responsabilidades fragmentadas amplifica o desperdício.
5. Confundir velocidade local com fluxo global
Mais código pode significar mais WIP, mais revisão, mais regressões e menor estabilidade. A organização celebra o estágio mais visível enquanto o tempo até valor aumenta.
14. Uma transição prática em 90 dias
Dias 0–30 — Tornar o fluxo visível
Resultado esperado: uma linha de base honesta e um piloto com limites claros.
- escolher um fluxo de valor real, não a organização inteira;
- mapear do problema ao readback de produção;
- medir filas, handoffs, WIP, retrabalho, falhas e tempo até evidência;
- classificar riscos e decisões que exigem autoridade humana;
- selecionar uma mudança pequena, útil e reversível;
- estabelecer a SPEC e o conjunto mínimo de evidências.
Dias 31–60 — Operar uma célula full-flow
Resultado esperado: uma mudança ponta a ponta aceita com evidência, não apenas um protótipo.
- reunir produto, engenharia e operação ao redor do resultado;
- usar Forge para contrato, risco, critérios e evidência;
- usar AI Works onde suas capacidades estiverem verificadas;
- automatizar testes, evals, segurança e captura de readback;
- liberar progressivamente e exercitar rollback;
- comparar tempo economizado com revisão e retrabalho introduzidos.
Dias 61–90 — Ampliar autonomia com base no resultado
Resultado esperado: uma capacidade organizacional repetível, e não uma demonstração isolada.
- transformar controles repetidos em golden paths;
- ampliar acesso do agente somente onde observação e reversão forem suficientes;
- manter aprovação independente para alto risco e efeitos externos;
- criar uma biblioteca de padrões, evals e falhas aprendidas;
- revisar métricas de fluxo, estabilidade, pessoas e resultado;
- decidir o que escalar, corrigir ou encerrar.
15. A evolução necessária da agilidade
A primeira geração de agilidade reagiu ao peso de ciclos longos, grandes especificações e feedback tardio. A próxima precisa reagir a um problema diferente: produção abundante sem confiança proporcional.
Com IA, a organização pode gerar mais hipóteses, protótipos, patches e alternativas do que consegue revisar, integrar e operar. O recurso escasso deixa de ser digitação. Passa a ser contexto confiável, julgamento, arquitetura, verificação, autoridade e aprendizado.
Por isso, o desenvolvedor do novo ciclo não é apenas frontend, backend ou “full stack” no sentido de acumular tecnologias. É alguém capaz de assumir responsabilidade pelo movimento completo de uma mudança:
Agilidade e IA não são adversárias. A IA torna mais necessária uma agilidade orientada a fluxo, evidência, feedback e responsabilidade.
- compreender a intenção;
- navegar o contexto;
- coordenar pessoas, agentes e especialistas;
- construir em pequenos lotes;
- provar o comportamento;
- respeitar o risco;
- colocar em operação;
- ler o resultado;
- aprender e ajustar.
“A pergunta não é quantas vezes mais rápido seu time escreve código. É quanto tempo sua organização leva para transformar uma intenção em uma mudança segura, observada e útil — e o que ela aprende quando o mundo responde.”
Convite à discussão
Se a IA já ajuda sua equipe a construir, quem hoje consegue conduzir a mudança inteira — do problema ao aprendizado em produção?
Se sua empresa quer mapear o SDLC AI-native, definir limites de autonomia, aplicar o Trustyu Forge e avaliar como AI Works pode apoiar o fluxo real, converse com Fernando Parreiras sobre advisory executivo, desenho operacional ou uma palestra para lideranças e times de tecnologia.
Fontes e natureza do texto
- Manifesto for Agile Software Development e seus princípios.
- DORA 2025 — State of AI-assisted Software Development.
- Google Cloud — anúncio e síntese do DORA 2025.
- DORA 2024 — Accelerate State of DevOps Report.
- DORA — Impact of Generative AI in Software Development.
- DORA — métricas de entrega de software.
- GitHub Copilot controlled experiment.
- The Effects of Generative AI on High-Skilled Work — três experimentos de campo.
- METR — Early-2025 AI and experienced open-source developer productivity.
- METR — atualização metodológica de fevereiro de 2026.
- SWE-bench — Can Language Models Resolve Real-world GitHub Issues?.
- SWE-Lancer — Can Frontier LLMs Earn $1 Million from Real-World Freelance Software Engineering?.
- The SPACE of Developer Productivity.
- Netflix — Full Cycle Developers: Operate What You Build.
- CNCF Platforms White Paper.
- Team Topologies — team interaction modeling.
- NIST SP 800-218 — Secure Software Development Framework.
- NIST SP 800-218A — Secure Software Development Practices for Generative AI.
- DORA — Continuous Delivery.
- Asleep at the Keyboard? — Assessing the Security of GitHub Copilot's Code Contributions.
- NIST AI Risk Management Framework.
Nota editorial e de responsabilidade
Este é um ensaio autoral de Fernando Parreiras, elaborado a partir de fontes públicas e documentação verificável das iniciativas Trustyu. Percentuais de produtividade foram preservados com seus contextos e limitações; resultados de estudos com ferramentas de 2024 ou 2025 não foram apresentados como taxa universal nem como medida atual de todos os agentes.
Pesquisa, triagem, estrutura e redação tiveram assistência de IA. Fernando Parreiras possui vínculo profissional e interesse comercial nas iniciativas Trustyu Forge e AI Works; por isso, capacidades implementadas, verificadas, operando e ainda previstas foram distinguidas explicitamente.
As seções sobre Trustyu Forge e AI Works foram confrontadas com os estados correntes de seus repositórios em 3 de novembro de 2026. O Forge canônico foi auditado em origin/main no SHA ceb06efe0a40650e910df3fd4f6650e9a963049e, seu runtime em e65c4c41b6ed56fe2d01f60afa19e7f97fb3b04d e o AI Works em e0e194568575a64af3cb03c038e4df1245dcc457. Esses identificadores registram a base da análise; não constituem, isoladamente, prova de deploy ou adoção.
A existência de um padrão, ferramenta ou componente não demonstra adoção integral, prontidão produtiva ou cobertura universal do SDLC. Segurança, conformidade e decisões de alto impacto exigem avaliação proporcional ao contexto e responsabilidade humana explícita.